1 引言:长轨迹的三类低效与既有方法的三大局限
基于 LLM 的智能体通过遵循一个计划(plan)来完成复杂软件工程任务:计划即系统提示词中规定的 issue 解决阶段序列,例如定位(localize)→ 复现(reproduce)→ 打补丁(patch)→ 验证(validate)[SWE-agent, 37]。然而在执行过程中,智能体可能偏离计划(drift away from the plan)[18],例如跳过验证;也可能表现出各类低效 [8, 19],例如重复动作与工具调用失败——这些既会直接导致任务失败,也会在智能体最终成功时仍抬高成本 [17]。摘要中所称的三类低效即:(i)偏离既定计划;(ii)重复失败的动作;(iii)在无可用补丁的情况下终止。现有的漂移纠正尝试存在三个主要局限:
1.1 局限一:把"判定"与"建议"折叠进单一机制
既往方法把判定(judging:轨迹是否陷入麻烦?)与建议(advising:智能体该做什么来摆脱麻烦?)合并为同一个机制:由一个建议者 LLM 兼任裁判去评估轨迹,再基于该评估为轨迹剩余部分推荐纠正动作 [31]。判定与建议本质上是相互冲突的任务:一个被提示"去诊断问题并给出纠正建议"的建议者,会被激励去"找出一个问题"——这与文献已充分记录的 LLM 迎合性偏置(sycophantic bias,倾向于迎合提示词本身的框架)[30] 一脉相承。其后果是:建议者可能凭空指出一个并不存在的问题,并强加误导性建议,使一场原本进展顺利的运行脱轨。克服此局限需要将判定与建议分离。
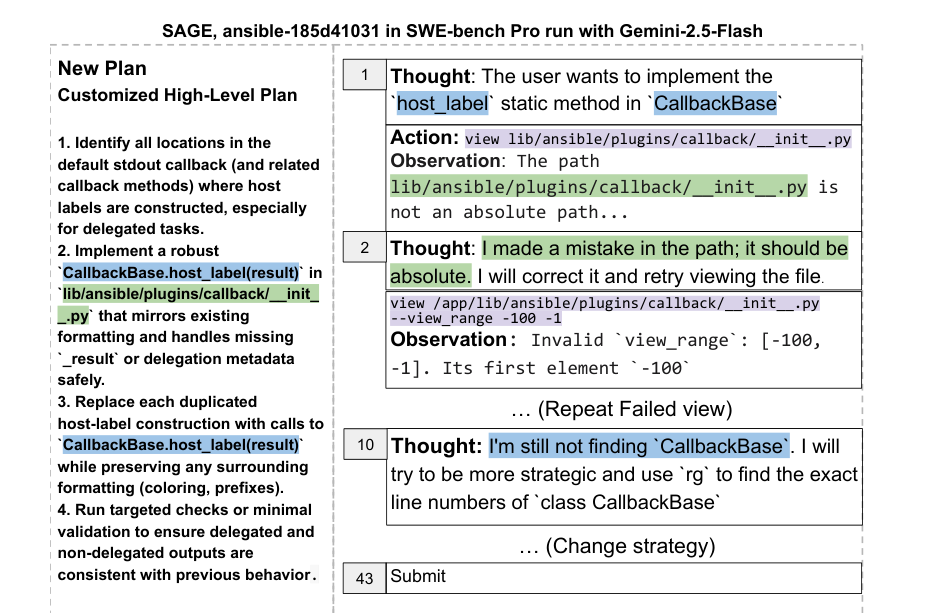
lib/ansible/plugins/callback/__init__.py 中实现 CallbackBase,而此类在仓库中并不存在;智能体在前 10 步中反复寻找这个不存在的文件,最终未打补丁即终止。1.2 局限二:LLM-as-a-judge 必须抉择"多久触发一次"
使用 LLM 裁判就要决定触发分析的时机。一类技术等到轨迹结束后做事后分析,再依据分析结果携带新计划重跑智能体 [8, 11, 27]:尽管建议者能提供从起步即引导智能体的全局计划,收益却附带风险——若计划有误(如图 1),被要求"遵循计划"的智能体可能无法察觉并恢复;同时把整条轨迹喂给建议者 LLM 并重跑智能体也十分昂贵。另一类技术周期性地让建议者评估轨迹的滑动窗口 [9, 10, 25]:频率过高 [9, 25] 则方法依然昂贵;频率过低 [10] 则引导反馈来得太晚,智能体已难以从失败模式中恢复。克服此局限要求只在必要时触发轨迹分析。
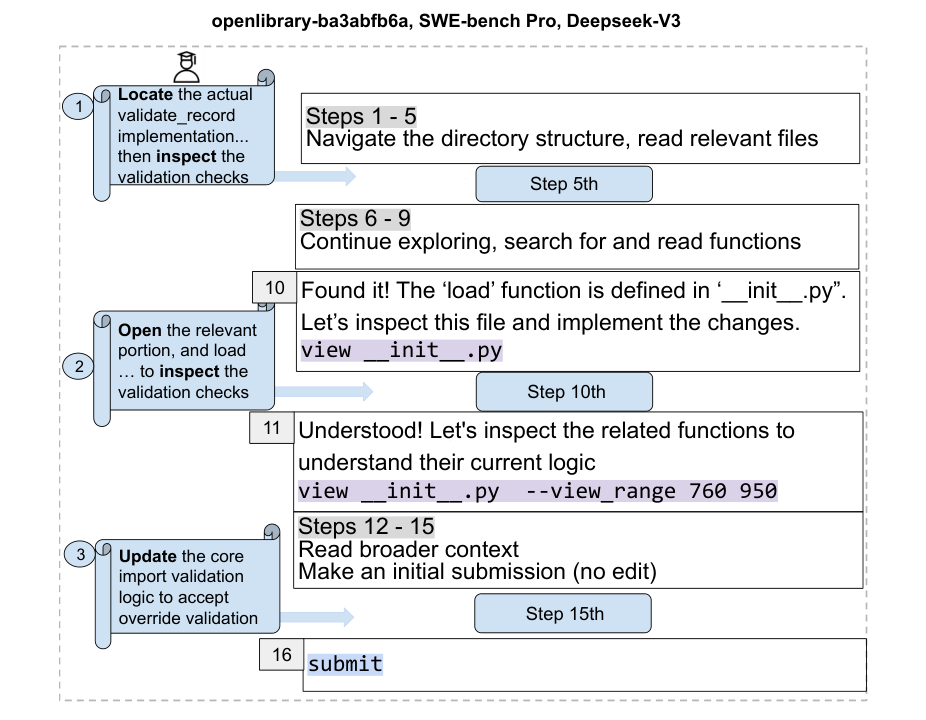
1.3 局限三:LLM 裁判的通用性以可靠性为代价
LLM-as-a-judge 的优势在于通用性——LLM 可凭内部知识标记未预先编码的问题;但其代价是可靠性:LLM 是出了名的不可靠评估者,既会漏报真实问题、也会误报不存在的问题 [8]。克服此局限需要一个能标记宽泛行为漂移类别的确定性裁判。
1.4 贡献
技术贡献。提出 LIVEPLAN 这一在线监控与干预技术,将判定与建议解耦:确定性规则监控器在不调用 LLM 的前提下检测轨迹是否以及何处陷入麻烦——因而不会幻觉出不存在的问题(§II-A);LLM 建议者仅在监控器触发时被咨询,且只负责一条高层次的下一步纠正(§II-B)。实证贡献。在两个广泛使用的 GitHub issue 数据集上开展大规模评估,共产生 7752 条轨迹(其中 4668 条由干预类方法生成),为后续研究提供了有价值的数据集;并对 LIVEPLAN 与各基线的成功/失败干预做了人工根因分析,给出干预失败的主要根因与未来研究指南。
2 核心设计:判定与建议解耦
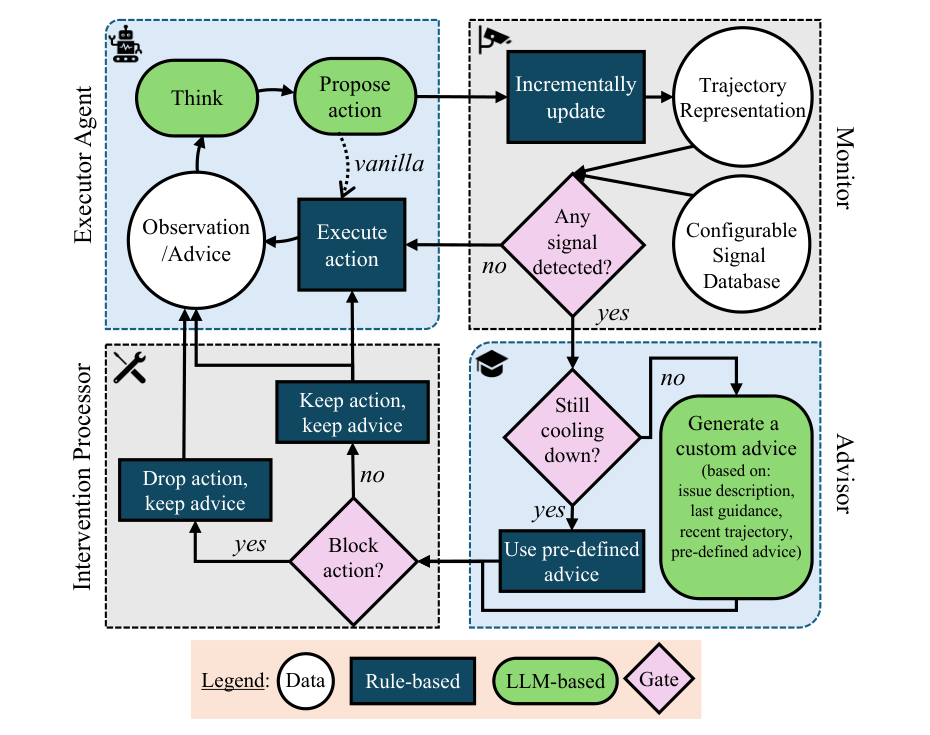
LIVEPLAN 对智能体轨迹做在线监控以检测行为漂移(behavioral drift),并以纠偏转向(corrective steering)进行干预。其设计的出发点正是第 1 节的三大局限:用确定性规则监视器承担"判定",从根本上消除裁判幻觉与裁判偏置;用按需触发的 LLM 建议者承担"建议",既保留通用知识又把调用次数压到最低。系统由三个组件构成(图 3):
- 监控器(Monitor):增量地构建过程中心式(process-centric)轨迹表示,将其与一组可配置的一般性信号比对以判定行为漂移,并在检出时唤起建议者(§II-A);
- 建议者(Advisor):返回与漂移对应的预定义建议,或在需要时提示 LLM 基于issue 描述、轨迹上下文、监控器状态与最近一次建议生成定制建议(§II-B);
- 干预处理器(Intervention Processor):依据最近动作与监控器观测,与执行智能体交互以完成纠偏转向(§II-C)。
值得强调的是,这些行为信号是一般性的,而非绑定于特定基准或仓库,因此能覆盖宽泛的行为漂移类别;同时 LIVEPLAN 维护一个可配置的信号数据库,用户可自行扩充。即便信号集合不完备,建议者 LLM 仍可运用其通用知识给出纠正引导,形成"确定性判定 + 生成式建议"的互补。
3 监控器:行为信号与检测规则
3.1 为什么不用 LLM 当裁判——连 rubric 也不够
常见做法是把整条轨迹(或其切片)喂给 LLM 审阅并发现问题,但 LLM 裁判易幻觉、易出错 [8, 30];更关键的是,当同一个 LLM 既判定又建议时,其引导建议会被自身的有偏评估所污染 [6, 14, 20, 30]。近期的 rubric 式判定 [29](让 LLM 按预定义信号给轨迹打分)虽约束了裁判、降低了幻觉与偏置,却未触及更深层的问题:评估仍依赖 LLM 正确且确定性地套用 rubric——在一个本就不确定的智能体之上再叠加一个不确定的裁判,只会放大而非抑制不稳定性。此外,单一提示词的 rubric 往往不够:可靠的判定可能需要装备工具的子智能体主动检查环境,成本大幅上升 [3]。LIVEPLAN 的选择是:判定完全交给确定性算法,零 LLM 调用、毫秒级开销。
3.2 两种过程中心式轨迹表示:GRAPHECTORY 与 LANGUTORY
监控器复用并扩充了 Liu 等人 [17] 提出的两种过程中心式表示,以通用方式编码行为漂移并用确定性算法检测:
- GRAPHECTORY:把轨迹转换为一张富化图——节点为不同的智能体动作,边为时序执行顺序。原版仅以动作为节点、思考作为节点属性;LIVEPLAN 为思考(thought)增加节点与边,从而也能监控以行为漂移形式表现出来的无效思考。
- LANGUTORY:把低层动作抽象为问题解决阶段的序列。LIVEPLAN 将原版的定位(localization)阶段细分为导航(navigation:定位潜在缺陷)与复现(reproduction:确认缺陷)两个阶段,并同步扩展 GRAPHECTORY 节点与 LANGUTORY 字母表,使监控与建议可以更具体地针对漂移。
3.3 行为漂移的定义与十类信号
行为漂移被定义为轨迹中偏离常见预期的状况。在此定义下:偏离既定计划、无法推进智能体的重复思考或动作、以及在任何问题解决阶段的停滞,都是行为漂移。部分漂移是告警性的(如提交前跳过补丁验证,可能导致错误补丁),应阻塞(block)相应动作的执行;另一些只是低效(如长时间的仓库导航——既可能源于无效推理/工具使用,也可能是为修复多 hunk 缺陷而 legitimately 收集上下文),允许执行但附加纠正建议。表 I 列出监控器可检测的十类阻塞/非阻塞行为漂移。
| 类型 | 类别 | 信号来源 | 行为漂移 | 描述 |
|---|---|---|---|---|
| 阻塞 (Blocking) | 计划违背 Plan Violation | LANGUTORY 中 跳过若干阶段 | 过早打补丁 Premature Patching | 先于定位阶段即打补丁 |
| 跳过打补丁 Skip Patching | 未产出补丁即收尾 | |||
| 跳过验证 Skip Validation | 未验证补丁即提交 | |||
| 振荡 Oscillation | GRAPHECTORY 中 重复的回边 | 思考振荡 Thought Oscillation | 无实质进展的重复推理模式 | |
| 动作振荡 Action Oscillation | 重复的执行循环,如自环或循环动作序列 | |||
| 非阻塞 (Non-blocking) | 长期停滞 Long Stagnation | LANGUTORY 中 同阶段长序列 | 长期导航 Prolonged Navigation | 在导航上耗费过多步骤 |
| 长期复现 Prolonged Reproduction | 长时间的缺陷复现 | |||
| 长期打补丁 Prolonged Patching | 连续执行过多编辑 | |||
| 长期验证 Prolonged Validation | 在验证上耗费过多精力 | |||
| 重复动作 Repeated Action | GRAPHECTORY 中 出现回边 | 动作重访 Action Revisit | 重复执行同一动作,如重访已看过的位置 |
注:阻塞类 5 种(3 计划违背 + 2 振荡)、非阻塞类 5 种(4 长期停滞 + 1 重复动作),合计十类。
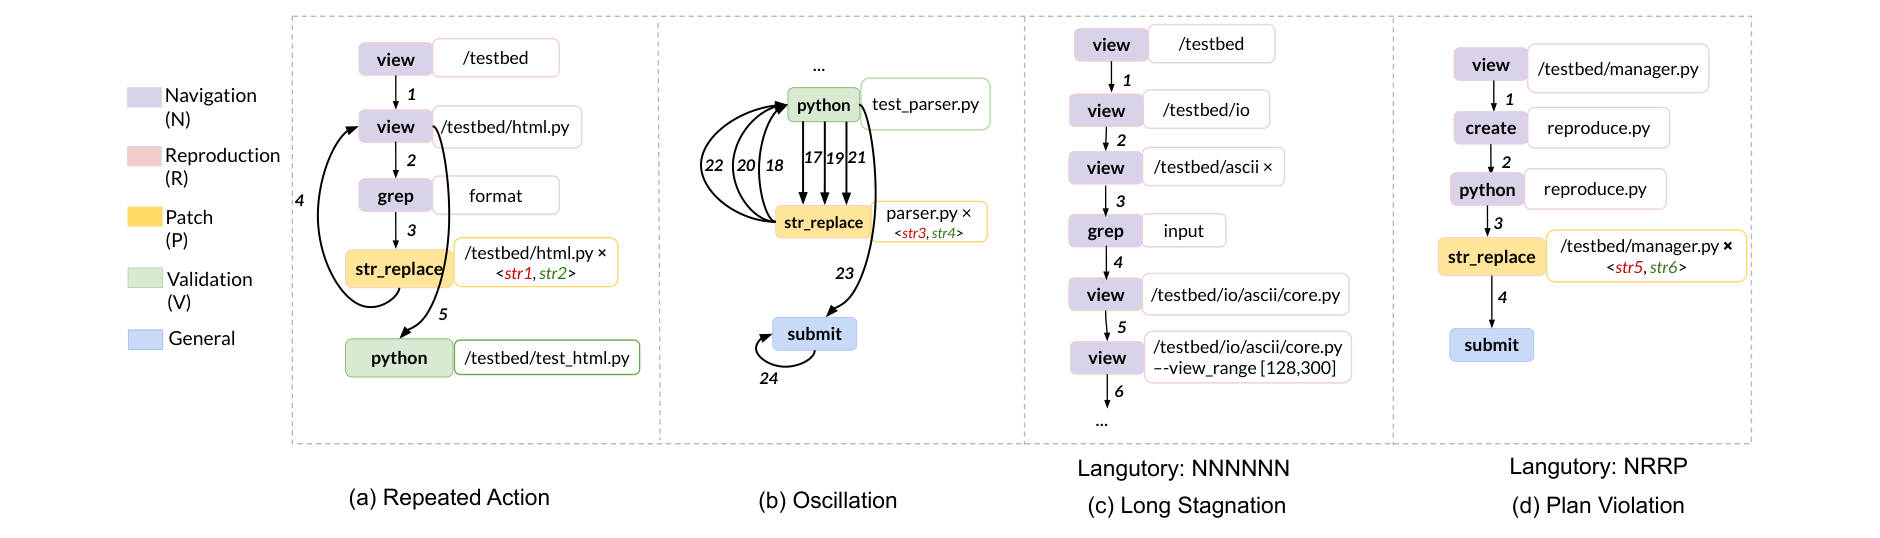
检测规则全部是图/序列上的确定性判定(图 4):GRAPHECTORY 中出现一条回边(无论动作性质如何)即指示"重复动作"(图 4a);重复的自环或多节点环指示"思考/动作振荡"(图 4b);LANGUTORY 中同一阶段的序列长度超过停滞阈值 $\theta_p$ 指示"长期停滞"(图 4c);LANGUTORY 中缺失某个阶段符号即意味着跳过计划阶段,为"计划违背"(图 4d)。
3.4 运行时算法(算法 1)
LIVEPLAN 的运行时监控与干预流程可概括为(对应原文 Algorithm 1):输入为 issue 描述 $I$、建议者冷却阈值 $\theta_c$、最大连续阻塞干预数 $\theta_i$、长期停滞阈值 $\theta_p$。每一步中,在执行者推理出下一动作之后、真正执行之前(第 7 行):监控器试探性地扩展 GRAPHECTORY/LANGUTORY 状态并检查规则(第 8–9 行);若无规则触发,则照常执行并记录、提交监控状态更新、将 blockCount 归零(第 10–13 行);若有规则触发(第 14–22 行)则取预定义建议,且当满足冷却条件时调用建议者 LLM:
随后由干预处理器裁决(第 23–31 行):若规则含阻塞类且连续阻塞干预数未达上限 $\theta_i$,则拒绝执行该动作、回滚试探性的表示更新(丢弃 $G‘$、$L’$)、把建议追加进执行者历史;否则(非阻塞漂移,或已达阻塞上限)放行动作执行、提交表示更新,并把建议追加到历史以引导后续决策。最后更新 latestAdvice 与 lastTrigger。
三个阈值在实验中的取值(详见 §6):$\theta_c=5$ 步、$\theta_p=7$ 步、$\theta_i=5$ 次。注意"试探性更新 + 回滚"的设计:被阻塞的动作不会污染监控状态,轨迹表示始终反映真实执行过的历史。
4 建议者机制:预定义建议与按需定制建议
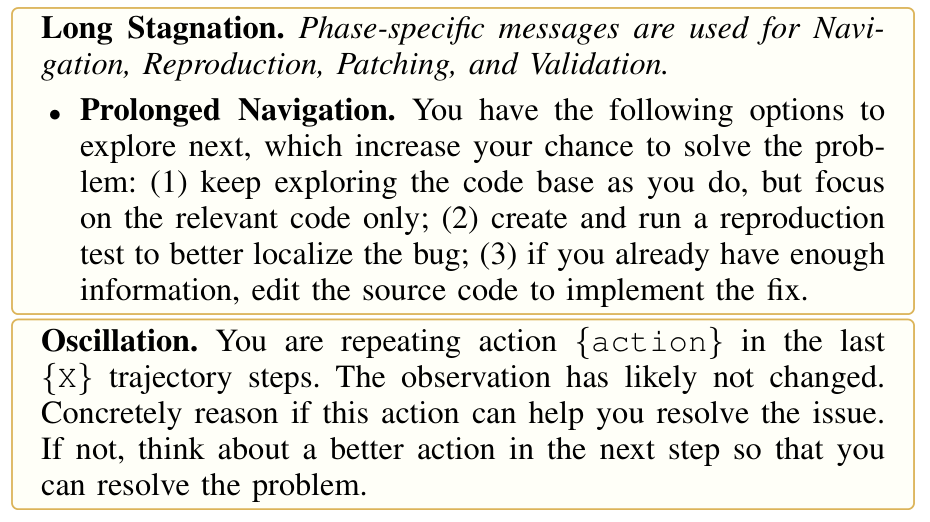
检出漂移后,建议者有两条路径。预定义建议(predefined advice)只提供与漂移相关、但与具体问题无关的高层次引导。例如对"长期导航"漂移(图 5):"接下来你有以下选择,可提高解题几率:(1) 继续像现在这样探索代码库,但只聚焦相关代码;(2) 创建并运行一个复现测试以更好地定位缺陷;(3) 若信息已足够,直接编辑源码实现修复。"对"动作振荡"漂移:"你在最近 {X} 步中重复动作 {action},观测大概率没有变化。请具体推理该动作是否真能帮助解决 issue;若不能,下一步想一个更好的动作。"这类消息虽切中所检出的漂移,却可能过于泛化而不足以帮执行者恢复,因此建议者还可调用 LLM 生成定制建议(custom advice)。
被调用时,LLM 建议者接收四个输入:(1) issue 描述;(2) 自上一次建议以来的已提交轨迹切片(而非整条轨迹,以最小化上下文);(3) 最近一次建议(若有);(4) 所检出漂移的预定义建议。预定义建议作为聚焦的高层提示,近期轨迹则是 grounding 建议的主要证据。建议者输出的是下一步(next-step)建议而非长程计划——干预因此保持聚焦,避免过度约束执行者,也避免上下文杂乱与退化 [16, 34, 35]。由于哪怕最小的上下文也会增加成本与延迟,LIVEPLAN 进一步实现冷却机制:只有距上一次 LLM 生成建议至少 $\theta_c$ 步之后才会再次调用 LLM。
5 干预处理器:阻塞与放行
干预处理器根据漂移类型执行两种动作之一:(1) 对阻塞漂移——在执行前拒绝肇事动作,丢弃试探性的 GRAPHECTORY/LANGUTORY 更新,并把建议追加到执行者历史以完成纠偏转向;该机制最多连续执行 $\theta_i$ 次,以防反复阻塞导致执行停滞(算法 1 第 23–25 行);(2) 对非阻塞漂移,或阻塞干预已达上限时——放行执行者,同时追加建议以引导其后续决策(第 26–31 行)。这样,"硬阻断"只保留给告警性漂移(如跳过验证就提交),其余情形以"软引导"处理,兼顾执行自主性与纠偏力度。
6 实现与实验设置
实现。LIVEPLAN 可插拔于任何开源的 ReAct 式 [38] 智能体;作者选择在 SWE-agent [37] 之上构建,因其实现稳定、经过充分测试。
基准。两个仓库级 issue 解决基准:SWE-bench Verified [12] 与 SWE-bench Pro [7](为控制成本使用其 Python 子集)——后者更具挑战性,且设计上抗数据污染。
基线与消融。(1) Vanilla:SWE-agent 使用其原定计划与执行 LLM;(2) SAGE [11]:用建议者 LLM 基于既有轨迹生成的新计划替换原计划(事后重规划 + 重跑);(3) 消融变体 Periodic Advisor:移除监控器,建议者周期性评估并干预轨迹(SWE-PRM [10] 与 Wink [25] 的最接近可复现类比——两者无可运行制品);(4) 消融变体 Predefined Advice:移除建议者 LLM,只用预定义消息干预([17] 的加强版——其制品未实现全部监控规则与信号,故此变体是该技术的性能上界)。
五个 LLM:3 个执行者 + 2 个建议者。执行者:DeepSeek-V3 [15](开源通用)、Gemini-2.5-Flash [5](轻量推理)、MiniMax-M2.5 [23](面向编码与智能体工作流优化)。建议者:GPT-5.2-Codex [26](中等推理力度)配对通用执行者 DeepSeek-V3 与 Gemini-2.5-Flash;MiniMax-M3 [24] 配对编码特化的 MiniMax-M2.5。配对原则:建议者必须强于执行者——不比执行者更强的建议者给不出执行者自身推理达不到的引导;所有干预方法使用相同配对,因此解决率差异反映的是干预机制而非建议者能力。
超参数。遵循 SWE-agent 与 SWE-bench Pro 默认配置:每实例成本上限 $2、温度 0。Periodic Advisor 每 5 步触发(与 SWE-PRM 设置一致);冷却期 $\theta_c=5$ 步。停滞阈值 $\theta_p=7$ 步——由干预前的 Vanilla SWE-agent 运行统计得出(所有模型上,已解决实例的平均最长同阶段长度为 5.64,未解决实例为 7.61),故该阈值在未偏向任何干预方法的前提下区分了"正常推进"与"疑似停滞"。阻塞干预上限 $\theta_i=5$。SAGE 按其提供的提示词与流水线原样运行。
7 实验结果
答:两个基准、全部三对模型上解决率一致提升,最高 +15.24 个百分点(Pro / Gemini-2.5-Flash);六组设置的增益均值为 9.9;新增解集中于 medium/hard 实例。
7.1 对比 Vanilla:增益数字逐项核对
| 建议者 | 执行者 | 方法 | 解决率 (%) | 平均成本 ($) |
|---|---|---|---|---|
| — | DeepSeek-V3 | Vanilla | 21.76 | 0.05 |
| GPT-5.2 | SAGE | 18.79 (−2.97) | 0.23 | |
| — | Predefined Advice | 25.00 (+3.24) | 0.11 | |
| GPT-5.2 | Periodic Advisor | 28.79 (+7.03) | 0.12 | |
| GPT-5.2 | LIVEPLAN | 34.09 (+12.33) | 0.15 | |
| — | Gemini-2.5-Flash | Vanilla | 13.17 | 0.78 |
| GPT-5.2 | SAGE | 18.18 (+5.01) | 1.16 | |
| — | Predefined Advice | 18.94 (+5.77) | 0.98 | |
| GPT-5.2 | Periodic Advisor | 26.14 (+12.97) | 0.84 | |
| GPT-5.2 | LIVEPLAN | 28.41 (+15.24) | 1.04 | |
| — | MiniMax-M2.5 | Vanilla | 52.5 | 0.24 |
| MiniMax-M3 | SAGE | 50.38 (−2.12) | 0.34 | |
| — | Predefined Advice | 54.17 (+1.67) | 0.23 | |
| MiniMax-M3 | Periodic Advisor | 54.54 (+2.04) | 0.32 | |
| MiniMax-M3 | LIVEPLAN | 57.95 (+5.45) | 0.24 |
| 建议者 | 执行者 | 方法 | 解决率 (%) | 平均成本 ($) |
|---|---|---|---|---|
| — | DeepSeek-V3 | Vanilla | 38.20 | 0.04 |
| GPT-5.2 | DeepSeek-V3 | LIVEPLAN | 49.40 (+11.20) | 0.08 |
| — | Gemini-2.5-Flash | Vanilla | 37.80 | 0.46 |
| GPT-5.2 | Gemini-2.5-Flash | LIVEPLAN | 48.40 (+10.60) | 0.58 |
| — | MiniMax-M2.5 | Vanilla | 74.20 | 0.30 |
| MiniMax-M3 | MiniMax-M2.5 | LIVEPLAN | 79.20 (+5.00) | 0.25 |
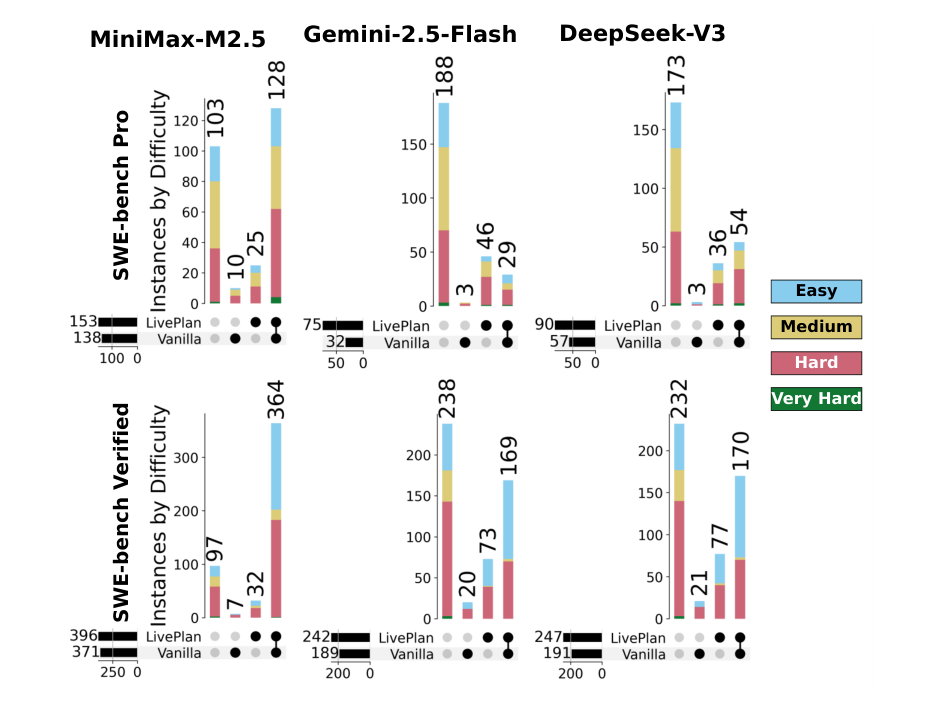
LIVEPLAN 在两个基准、全部模型对上稳定高于 Vanilla。增益在 Pro 上更大:DeepSeek-V3 与 Gemini-2.5-Flash 分别 +12.33 / +15.24 个百分点,对照 Verified 上的 +11.20 / +10.60;即便对强模型 MiniMax-M2.5,仍有 Pro +5.45、Verified +5.00。成本方面:DeepSeek-V3 与 Gemini-2.5-Flash 仅温和上升,MiniMax-M2.5 上成本反而下降($0.30→$0.24,Verified;Pro 持平 $0.24)。六组设置的增益(12.33、15.24、5.45、11.20、10.60、5.00)平均即摘要所称的 9.9;六组成本差(+0.10、+0.26、0.00、+0.04、+0.12、−0.05)平均即 +$0.08/实例。
7.2 对比 SAGE:具体的计划为何反而更糟
LIVEPLAN 以更低成本一致超越 SAGE。SAGE 的显著开销来自"跑一遍 Vanilla → 整条轨迹喂给建议者重规划 → 带新计划重跑智能体"的完整流程;在 DeepSeek-V3 与 MiniMax-M2.5 下 SAGE 甚至低于 Vanilla(Pro 上分别 −2.97 与 −2.12)。根因颇具启示:SAGE 产出的指导往往极其具体——精确到行号、可直接插入的代码片段——但这类细节常常事实性错误(图 1);而执行者 LLM 通常较弱,无法批判性评估或从错误指令中恢复,反而忠实跟随幻觉出的指导,最终任务失败。这印证了判定/建议不分离时"越具体越危险"的失效模式。
7.3 消融:监控器与建议者缺一不可
移除监控器(Periodic Advisor)或移除建议者(Predefined Advice)都会降低 LIVEPLAN 的表现,证明两个组件的必要性。SWE-PRM(每 5 步)与 Wink(每步)等周期性技术"保证触发"建议者,LIVEPLAN 则按需触发。表 IV 给出触发频率:Periodic Advisor 几乎在所有轨迹中触发建议者(96%–99.6%,未触发的仅为早于五步即失败终止的短轨迹),LIVEPLAN 的触发率为 83.3%–93.9%,平均干预次数也更低——但 Periodic Advisor 触发更多、更密,性能却更低,人工分析确认其原因是建议者给出误导性建议(如图 2 的误诊)。值得注意的是,用 DeepSeek-V3 与 Gemini-2.5-Flash 时 LIVEPLAN 每实例成本反而高于 Periodic Advisor——多出的成本来自更长的成功轨迹(更多问题被真正解完),而非更昂贵的干预本身。对照 Predefined Advice:LIVEPLAN 以可观幅度稳定占优,因为纯预定义消息常常不足以帮执行者从漂移中恢复;且该变体检测的问题集比 [17] 更广、已是后者性能上界,LIVEPLAN 对 [17] 的真实优势只会更大。
| 建议者 | 执行者 | 方法 | 平均干预次数 | 触发率 (%) |
|---|---|---|---|---|
| GPT-5.2 | DeepSeek-V3 | Periodic Advisor | 3.25 | 99.6 |
| LIVEPLAN | 2.33 | 93.9 | ||
| GPT-5.2 | Gemini-2.5-Flash | Periodic Advisor | 7.37 | 97.7 |
| LIVEPLAN | 2.99 | 93.9 | ||
| MiniMax-M3 | MiniMax-M2.5 | Periodic Advisor | 7.38 | 99.6 |
| LIVEPLAN | 1.47 | 83.3 |
答:建议者每实例仅 $0.01–$0.06;规则监控近零开销(毫秒级);对 Gemini/MiniMax 还常缩短轨迹乃至降低总成本。
| 基准 | 建议者 | 执行者 | 方法 | 步数 | Exec 成本 ($) | Adv 成本 ($) | Mon 开销 | Adv 延迟 (s) |
|---|---|---|---|---|---|---|---|---|
| Pro | — | DeepSeek-V3 | Vanilla | 16 | 0.04 | — | — | — |
| GPT-5.2 | LIVEPLAN | 30 | 0.12 | 0.04 | ≈0 | 10.9 | ||
| — | Gemini-2.5-Flash | Vanilla | 75 | 0.78 | — | — | — | |
| GPT-5.2 | LIVEPLAN | 47 | 0.98 | 0.06 | ≈0 | 9.6 | ||
| — | MiniMax-M2.5 | Vanilla | 47 | 0.24 | — | — | — | |
| MiniMax-M3 | LIVEPLAN | 47 | 0.24 | 0.01 | ≈0 | 29.1 | ||
| Verified | — | DeepSeek-V3 | Vanilla | 21 | 0.04 | — | — | — |
| GPT-5.2 | LIVEPLAN | 24 | 0.06 | 0.02 | ≈0 | 5.8 | ||
| — | Gemini-2.5-Flash | Vanilla | 52 | 0.46 | — | — | — | |
| GPT-5.2 | LIVEPLAN | 38 | 0.55 | 0.04 | ≈0 | 8.1 | ||
| — | MiniMax-M2.5 | Vanilla | 70 | 0.30 | — | — | — | |
| MiniMax-M3 | LIVEPLAN | 58 | 0.23 | 0.02 | ≈0 | 39.5 |
所有设置下建议者成本仅 $0.01–$0.06/实例,规则监控的开销近零(毫秒级),建议者延迟相对长程仓库级修复任务的运行时间也属温和。除成本之外,LIVEPLAN 常通过减少无效探索降低执行开销:对 Gemini-2.5-Flash 与 MiniMax-M2.5,干预总体上缩短了轨迹(Pro:75→47 步;Verified:70→58 步),个别情况下总成本不升反降;DeepSeek-V3 的轨迹则变长(16→30、21→24 步),因为 LIVEPLAN 遏制了其"跳过验证"之类的常见捷径 [18],促使其完成更完整、可靠的修复流程——即便如此,总开销增幅仍然很小。
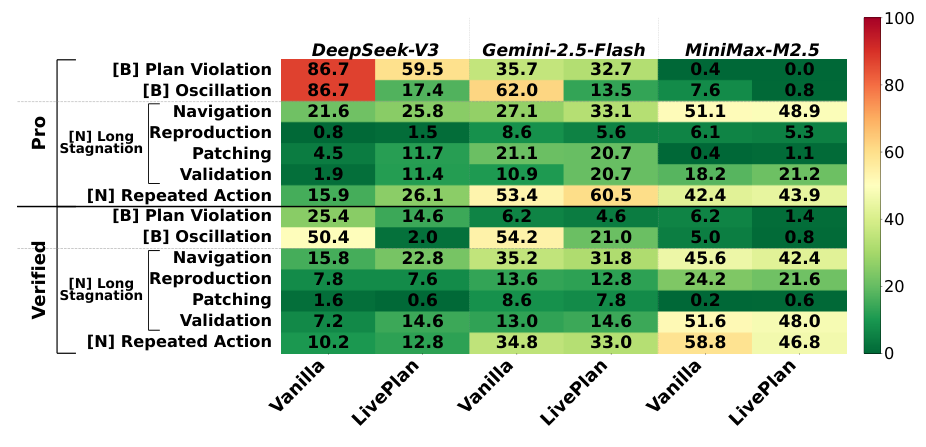
答:Vanilla 轨迹 78%–86% 存在行为漂移;LIVEPLAN 将最终轨迹中的阻塞漂移占比从 55.63%/40.27% 压到 34.37%/13.67%;计划合规度(PC)主要经由 PPC/POC 提升;干预后策略显著改道(Wilcoxon p<1e-10)。
7.4 触发信号的普遍性
对 Vanilla 与 LIVEPLAN 完成的轨迹测量漂移流行度(图 8),并统计 LIVEPLAN 执行期间观测到各漂移的实例占比(表 VI)。Vanilla 轨迹中平均 86.16%(Pro)与 78.33%(Verified)存在行为漂移;Pro 上更普遍——问题更复杂、轨迹更长、更易漂移。Vanilla 中的漂移未必原样出现在 LIVEPLAN 最终轨迹里,因为 LIVEPLAN 会把智能体引离它们。最终轨迹中的阻塞漂移占比从 Vanilla 的 55.63%(Pro)与 40.27%(Verified)降至 LIVEPLAN 的 34.37% 与 13.67%;残留者主要因执行者无法或不愿遵循建议、在超过连续干预上限 $\theta_i$ 后重犯。非阻塞信号可以留在完成轨迹中——它们既可能标记低效,也可能是解难题所必需的 legitimate 长期尝试。总体表明 LIVEPLAN 在最小化高风险漂移的同时保留了长程任务所需的灵活性。
| 基准 | 建议者 | 执行者 | PV | 停滞:导航 | 停滞:复现 | 停滞:补丁 | 停滞:验证 | Osc | RA |
|---|---|---|---|---|---|---|---|---|---|
| SWE-bench Pro | GPT-5.2 | DeepSeek-V3 | 80.7 | 26.1 | 1.5 | 11.4 | 11.0 | 95.5 | 28.8 |
| GPT-5.2 | Gemini-2.5-Flash | 43.9 | 31.8 | 5.3 | 20.5 | 20.8 | 73.5 | 59.5 | |
| MiniMax-M3 | MiniMax-M2.5 | 1.9 | 48.7 | 5.3 | 1.1 | 21.3 | 10.3 | 44.1 | |
| SWE-bench Verified | GPT-5.2 | DeepSeek-V3 | 28.2 | 22.8 | 7.4 | 0.6 | 14.6 | 37.0 | 12.8 |
| GPT-5.2 | Gemini-2.5-Flash | 7.7 | 34.9 | 13.8 | 8.4 | 15.7 | 78.3 | 37.8 | |
| MiniMax-M3 | MiniMax-M2.5 | 6.2 | 42.4 | 21.2 | 0.6 | 47.8 | 6.8 | 47.0 |
7.5 计划合规度分析
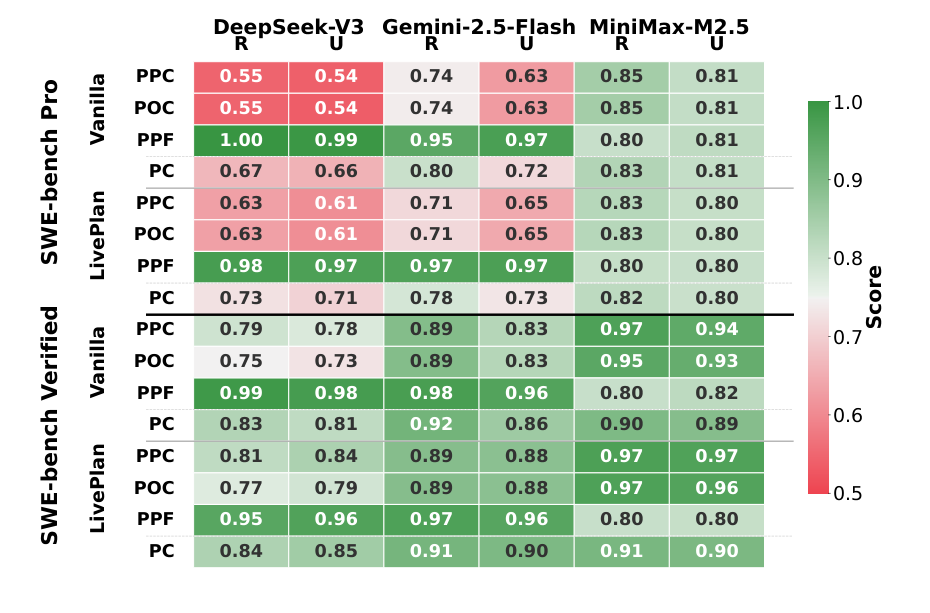
沿先前工作 [18],以四个指标度量轨迹对 SWE-agent 修复计划(导航→复现→补丁→验证)的遵循度:PPC(Plan Phase Compliance,惩罚跳过阶段)、POC(Plan Order Compliance,惩罚乱序执行)、PPF(Plan Phase Fidelity,惩罚计划外行为),总分 PC 取三者几何平均——仅当轨迹"不多不少、按序"执行全部指定阶段时 PC=1:
图 9 显示:与先前工作一致,已解决轨迹的 PC 高于未解决轨迹,说明成功修复大多遵循预期工作流。LIVEPLAN 的 PC 提升主要来自更高的 PPC 与 POC——在线干预帮助智能体按序完成必需阶段;PPF 偶尔低于 Vanilla,归因于建议者推荐了有益的计划外动作(如额外的回归测试来验证补丁);由于这些轨迹最终成功,其计划外行为是生产性的而非漫无目的。
7.6 策略分歧分析:干预前相似、干预后改道
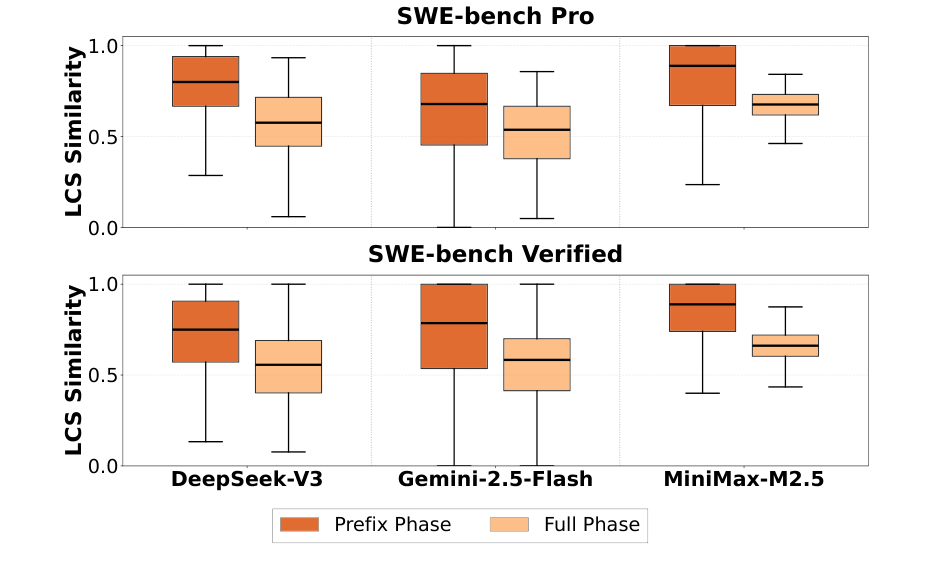
独立于计划,作者对 Vanilla 与 LIVEPLAN 做逐实例的同类比较:以 LANGUTORY 序列的归一化最长公共子序列(LCS)相似度度量执行行为的接近程度:
分别在 (1) 首次干预之前的 LANGUTORY 前缀与 (2) 完整轨迹上计算:前者刻画执行非确定性带来的分歧(干预前两次运行独立演化),后者叠加非确定性与在线干预的合并效应。图 10 显示前缀相似度很高(常在 0.8–0.9),说明智能体起初策略相近;干预之后相似度一致下降,说明 LIVEPLAN 确实重定向了后续解题策略。逐实例配对的单侧 Wilcoxon 符号秩检验证实其显著性:每个"模型×基准"组合中前缀相似度均显著更高(中位配对差 > 0,p < 1e−10)。由于前缀与全轨迹按实例配对、难度固定,干预后的下降反映的是干预本身而非任务差异——LIVEPLAN 的性能增益源自有针对性的行为纠正,而非运行间随机波动。
答:LIVEPLAN 的 R→U 回归最少(Pro 上仅 2/2/7),U→R 改进多;244 个 U→R 案例中 74.6% 获多次干预(平均 3.70 次),且全部在轨迹前三分之一内首次干预;几乎所有 LIVEPLAN 回归的根因是执行者未能遵循正确的建议,而非建议错误或干预迟到。
7.7 解决状态转移矩阵
| 基准 | 方法 | R→U 回归 ↓ | U→R 改进 ↑ | ||||
|---|---|---|---|---|---|---|---|
| DS | GF | MM | DS | GF | MM | ||
| SWE-bench Pro | SAGE | 26 | 12 | 22 | 19 | 28 | 16 |
| Predefined Advice | 16 | 13 | 15 | 25 | 28 | 15 | |
| Periodic Advisor | 16 | 11 | 17 | 35 | 42 | 22 | |
| LIVEPLAN | 2 | 2 | 7 | 33 | 38 | 21 | |
| SWE-bench Verified | LIVEPLAN | 12 | 7 | 7 | 56 | 68 | 28 |
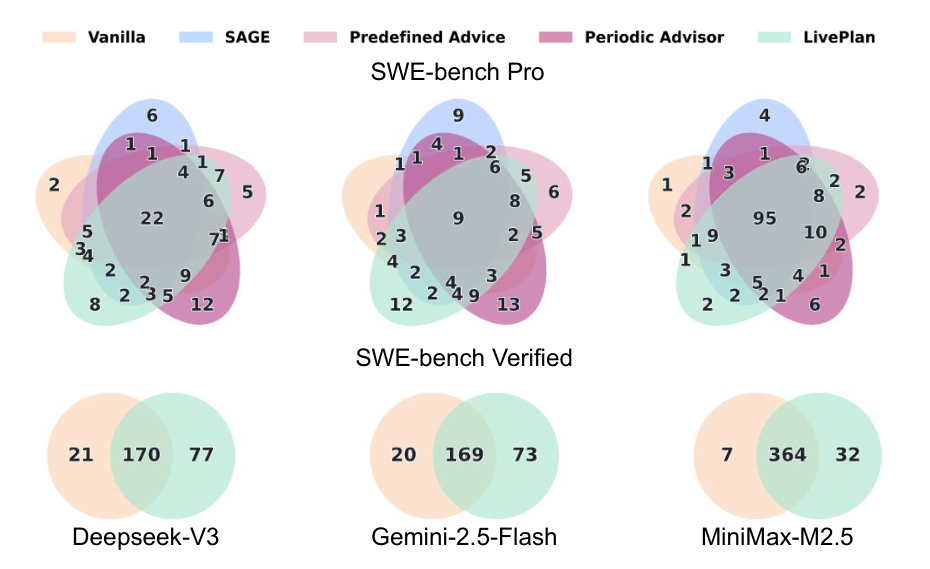
LIVEPLAN 的 R→U 回归在所有方法中最少,同时产出大量 U→R 改进(Pro 上尤为显著):既把一批 Vanilla 失败的实例转成成功,又保住了 Vanilla 的既有成功。(脚注:Periodic Advisor 在个别设置中 U→R 略多,但其 R→U 回归也多得多,总解决率仍低于 LIVEPLAN。)
7.8 人工根因分析
两位作者独立检查轨迹、干预、产出补丁与金补丁,以归纳方式(类别在分析中涌现并打磨,而非预先定义)识别根因,再讨论达成一致。改进(U→R)的三个来源:
- 纠正行为漂移。较弱的执行者(尤其 DeepSeek-V3 与 Gemini-2.5-Flash)频繁出现阻塞漂移(表 VI);LIVEPLAN 及时检出并在漂移固化前重定向——在受影响的轨迹中消除了 104/128(81.3%)的振荡、37/72(51.4%)的计划违背。
- 重新聚焦修复任务。随轨迹变长,执行者可能因累积上下文或中间失败而偏离主任务(上下文中毒,context poisoning [3]);建议者以 issue 描述与近期步骤为条件,把执行者从无产出的探索拉回核心问题。
- 渐进式在线纠正。182/244(74.6%)的 U→R 案例获得多次干预(244 例平均 3.70 次),使 LIVEPLAN 能持续纠正新出现的漂移而非依赖一次性重定向;且在全部 244 个 U→R 案例中,首次干预都发生在轨迹前三分之一内,留有足够的转向余地。
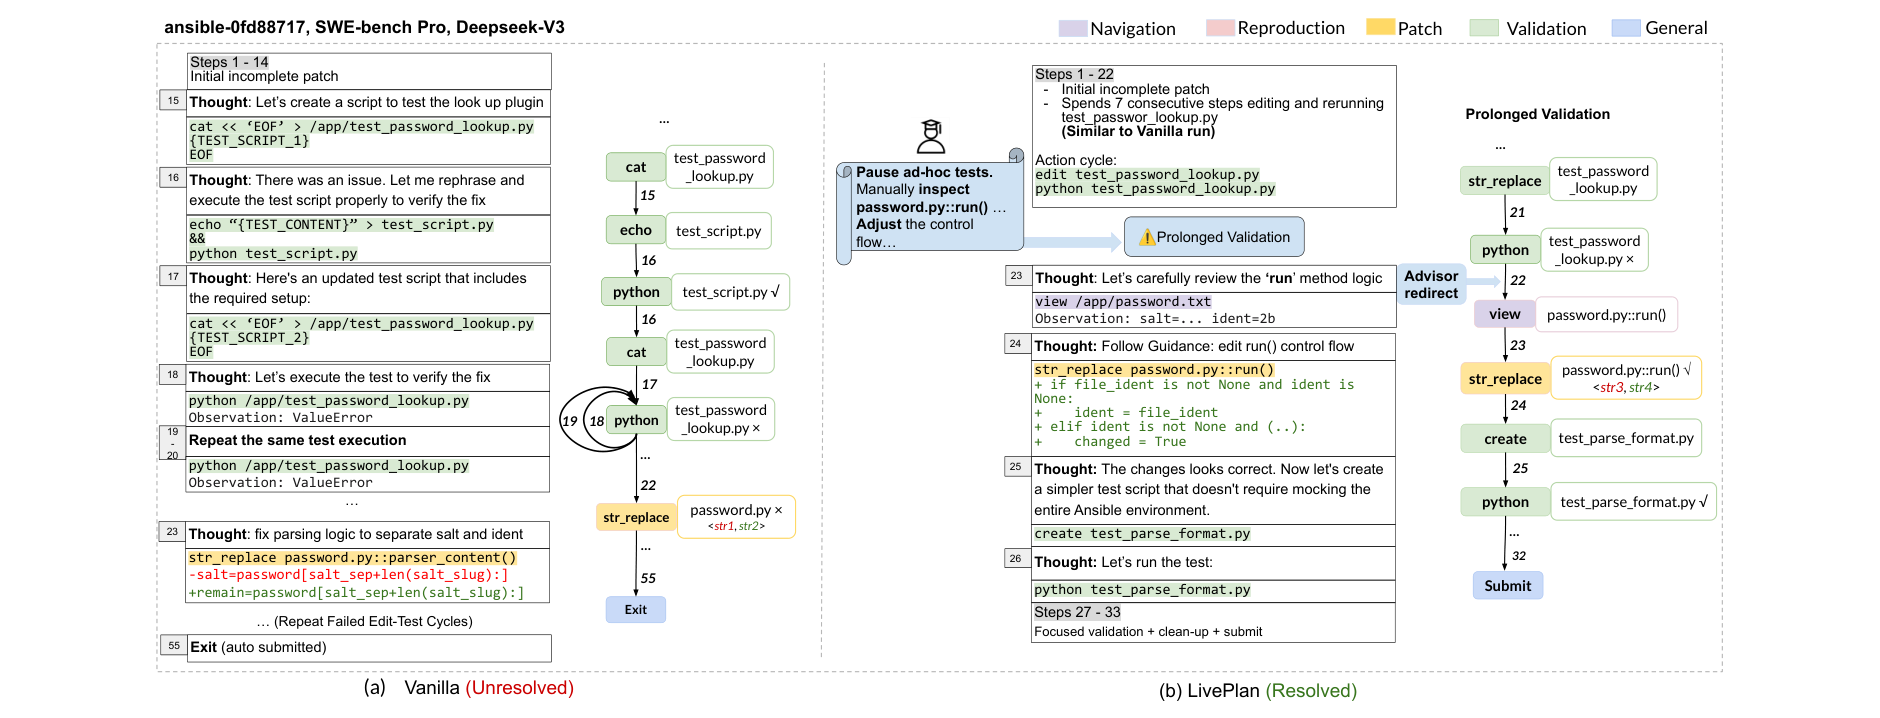
password.py::run() 的核心逻辑";执行者遵循引导修正控制流、做聚焦验证,第 33 步成功提交补丁。回归(R→U)的五类来源(各方法表现不同):(1) 误导或低质引导——SAGE 可能生成指向不存在问题的错误全局计划(图 1);Predefined Advice 常不足以支撑任务特定的修复;Periodic Advisor 可能误诊轨迹状态给出无用引导(图 2)。(2) 执行非确定性——重跑可能在任何干预之前就偏离 Vanilla 执行,出现原轨迹没有的失败。(3) Vanilla 的侥幸成功——一些 Vanilla 运行在导航/验证缺失或极少的情况下碰巧成功,可能源于记忆/数据污染 [1] 而非正确推理,使纠正性干预反而"添乱"。(4) 不完全遵循——执行者未能忠实执行或充分落实正确的建议。(5) 次要任务分心——建议可能有意把执行者引向次要问题(如环境配置),使其偏离主修复任务。
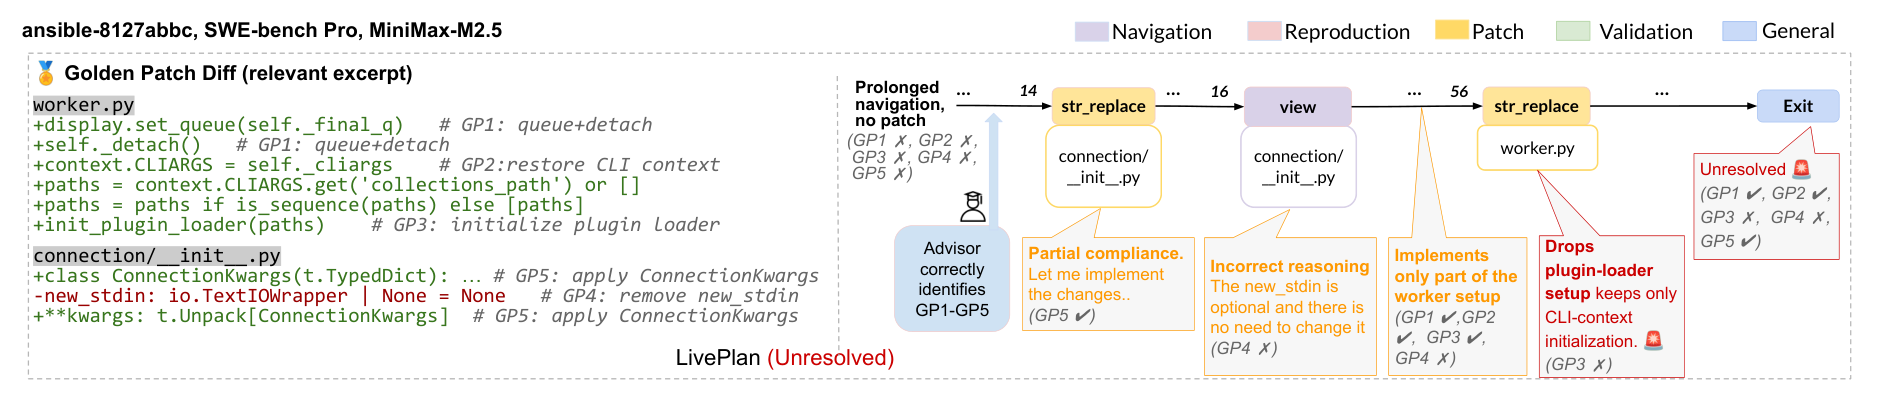
关键结论:几乎所有 LIVEPLAN 的 R→U,根因都不是建议错误或干预迟到,而是执行者无力遵循正确的引导(作者对照金补丁确认了建议的准确性)。图 12 的案例(ansible-8127abbc,Pro,MiniMax-M2.5)即是典型:监控器检出长期导航且未打补丁,第 14 步触发建议者;建议者正确识别出与金补丁一致的全部五个关键修复要素(GP1–GP5)并指示开始编辑;执行者只落实了部分(第 14 步改 GP5),随后在第 56 步错误地推断"GP3 的编辑不对"并将其回滚,最终提交了残缺补丁;相反,Vanilla 虽导航到第 24 步,却收集齐了生成成功补丁所需的全部上下文。
面向未来研究的指南。推理时干预应辅以干预感知的后训练(intervention-aware post-training):LIVEPLAN 决定"何时、如何"转向执行,但成功恢复取决于执行者忠实落实建议。未来可在干预条件化的轨迹上、用过程级奖励(鼓励执行者在后续步骤满足显式引导约束)训练执行者——因为仅优化最终任务成功率会助长脆弱、欠验证的解法。分工是互补的:LIVEPLAN 决定何时给、给什么建议;训练后的执行者学会可靠地把建议转化为正确解。此外,鉴于观察到的执行非确定性,评估应使用重复配对 rollout 来估计干预如何改变解决概率,而非从单一轨迹下结论。
答:在两次 Vanilla 重复运行结果一致的确定性子集上,方法排序与增益幅度保持;Verified 的 DeepSeek-V3 重复验证中解决率 36.58%→46.56%,与全集增益一致。
7.9 非确定性子集上的复检
作者在 SWE-bench Pro 上取两次重复 Vanilla 运行结果一致的实例子集重新评估所有方法。该子集保留了各模型研究实例的 84%、80%、88%;其难度分布与全集相近(全集:easy 20.3% / medium 41.0% / hard 36.8% / very hard 1.9%;DeepSeek-V3 子集:19.4/40.1/38.3/2.3;Gemini-2.5-Flash:21.1/39.4/37.6/1.9;MiniMax-M2.5:21.8/40.2/36.3/1.7)。由于子集仅由 Vanilla 的一致性定义,不会选择性偏袒或惩罚任何方法。结果(表 VIII):LIVEPLAN 保持表 II 的方法排序,在所有模型上取得最高解决率,其后依次为 Periodic Advisor、Predefined Advice、Vanilla,且优势幅度与全研究相当——增益并非基线波动的伪象。作者进一步重复了 SWE-bench Verified 上 DeepSeek-V3 的 Vanilla 运行(为控制实验成本仅验证一个模型),LIVEPLAN 再次显著胜出:解决率从 36.58% 提升到 46.56%,幅度与全集增益一致。
| 建议者 | 执行者 | 实例数 | 方法 | 解决率 (%) |
|---|---|---|---|---|
| — | DeepSeek-V3 | 222 | Vanilla | 19.82 |
| GPT-5.2 | SAGE | 16.67 (−3.15) | ||
| — | Predefined Advice | 20.27 (+0.45) | ||
| GPT-5.2 | Periodic Advisor | 23.87 (+4.05) | ||
| GPT-5.2 | LIVEPLAN | 27.03 (+7.21) | ||
| — | Gemini-2.5-Flash | 213 | Vanilla | 8.92 |
| GPT-5.2 | SAGE | 11.74 (+2.82) | ||
| — | Predefined Advice | 12.68 (+3.76) | ||
| GPT-5.2 | Periodic Advisor | 18.31 (+9.39) | ||
| GPT-5.2 | LIVEPLAN | 18.78 (+9.86) | ||
| — | MiniMax-M2.5 | 234 | Vanilla | 52.99 |
| MiniMax-M3 | SAGE | 50.00 (−2.99) | ||
| — | Predefined Advice | 52.99 (+0.00) | ||
| MiniMax-M3 | Periodic Advisor | 54.27 (+1.28) | ||
| MiniMax-M3 | LIVEPLAN | 56.41 (+3.42) |
8 相关工作
轨迹分析与失败诊断。Liu 等 [17] 提出基于结构化图与语言抽象的过程中心式轨迹表示(LIVEPLAN 的监控基础);Chen 等 [4] 与 Liu 等 [19] 对 GitHub issue 解决轨迹做过程导向的错误分析;TRAIL [8] 与 MAST [27] 建立失败分类学;FALAT [28] 与 AgentRx [2] 提供步级失败定位框架。这些工作只做事后分析、不在执行中介入;LIVEPLAN 则持续监控执行并在检出漂移时干预,在错误传播之前纠正行为。
在线引导、规划与自纠正。Self-Refine [22] 与 LATS [40] 用迭代自反思,但面向无状态推理而非长程智能体执行。规划类方法——Plan-and-Act [9]、EAGLET [32]、ReCAP [39]——将规划与执行解耦或学习更强的规划器。面向软件工程智能体:SAGE [11] 从已完成轨迹重生成计划并重跑执行者;SWE-PRM [10] 与 Wink [25] 周期性地在近期窗口上调用 LLM 评估器;TrajEval [13] 将细粒度轨迹与参考补丁比对。LIVEPLAN 避免了周期性 LLM 判定与不必要干预,同时给出有针对性的下一步建议,在所有设置中取得最高解决率,且建议者干预次数大幅更少。
9 效度威胁
外部效度。为确保可推广性,在两个真实 GitHub issue 基准上评估三个执行者与两个建议者 LLM,并与四个基线及近似相关工作的消融版本比较;为计入执行非确定性,进一步在两次重复 Vanilla 执行结果一致的实例子集上复评,观察到对 Vanilla 的相似改进,说明方法对运行间波动稳健。内部效度。不仅考察结果,也考察过程(过程中心分析)。构念效度。流水线建立在同行评审的制品之上,使用经过充分校验的工具;定量与定性分析相互印证,避免错误的指标实现或测量。
10 结论
LIVEPLAN 为编程智能体提供轻量级监控与纠偏转向:依托 GRAPHECTORY 与 LANGUTORY 两种抽象表示监控并判定行为漂移,配合相关的预定义建议或按需的 LLM 定制建议。其代价极小(每实例约 +$0.08、监控毫秒级),收益稳定(最高 +15.2、平均 +9.9 个百分点),且几乎不伤及原本成功的运行。下一步方向是干预感知的后训练——让执行者学会可靠地把正确建议转化为正确解。制品已开源(github.com/Intelligent-CAT-Lab/Agent-Planner);本研究受 NSF CCF-2238045 与 IBM-Illinois Discovery Accelerator Institute(IIDAI)资助。
关键术语中英对照
| 中文 | 英文 |
|---|---|
| 纠偏转向 | corrective steering |
| 判定与建议解耦 | decoupling judging from advising |
| 行为信号 | behavioral signals |
| 行为漂移 | behavioral drift |
| 确定性规则监控器 | deterministic, rule-based monitor |
| 预定义建议 / 定制建议 | predefined advice / custom advice |
| 阻塞 / 非阻塞漂移 | blocking / non-blocking drift |
| 计划违背 / 振荡 / 长期停滞 / 重复动作 | plan violation / oscillation / long stagnation / repeated action |
| 干预处理器 | intervention processor |
| 冷却机制 | advisor cooldown |
| 过程中心式轨迹表示 | process-centric trajectory representation(GRAPHECTORY / LANGUTORY) |
| 计划合规度 | plan compliance(PPC / POC / PPF / PC) |
| 最小回归 | minimal regression on already successful runs |
| 干预感知的后训练 | intervention-aware post-training |